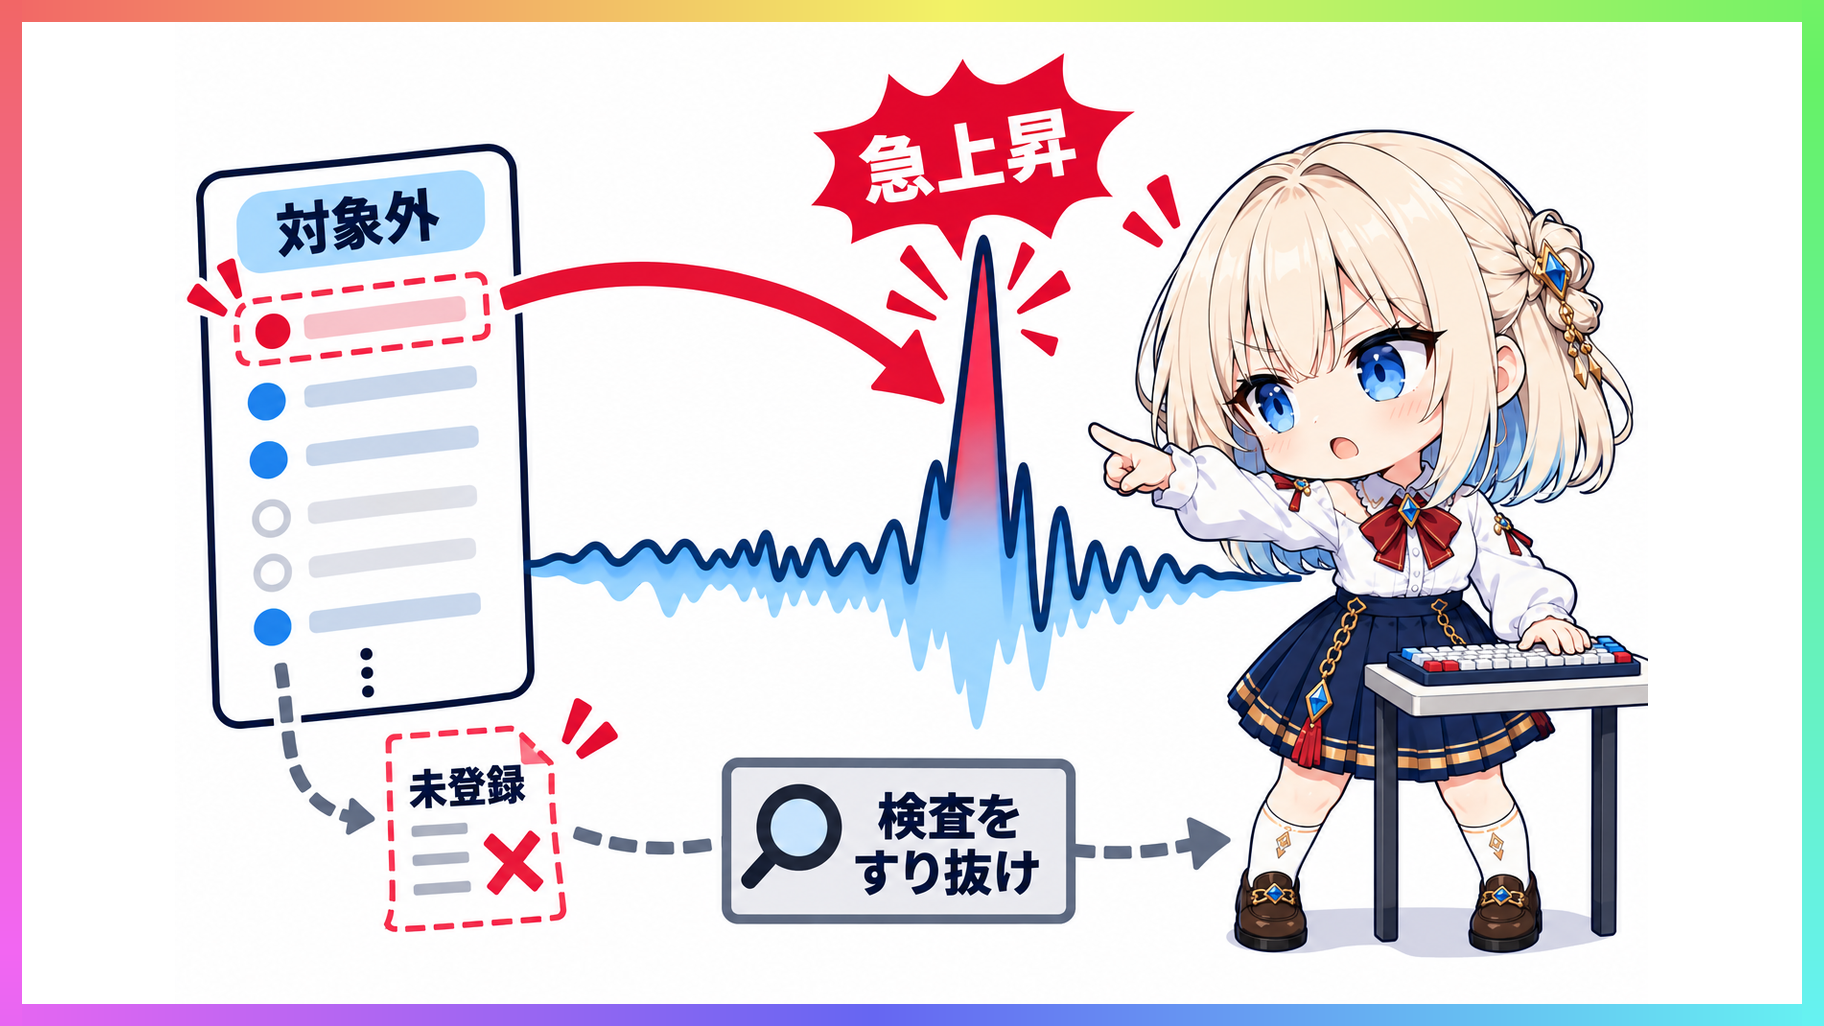
ネット上の話題を拾って短い動画を作る自作ツールの出力を聞いていたら、「準備していたんだって」のイントネーションが耳に引っかかった。不自然な高低差で完全に音割れのような違和感がある。
頭高型のはずの句なのに、アクセント核の直後でピッチが6.0半音も跳ね上がっていた。
それなのに自動品質検査は何の警告も出さずにパスしていた。
検査通過と跳ね上がったピッチ
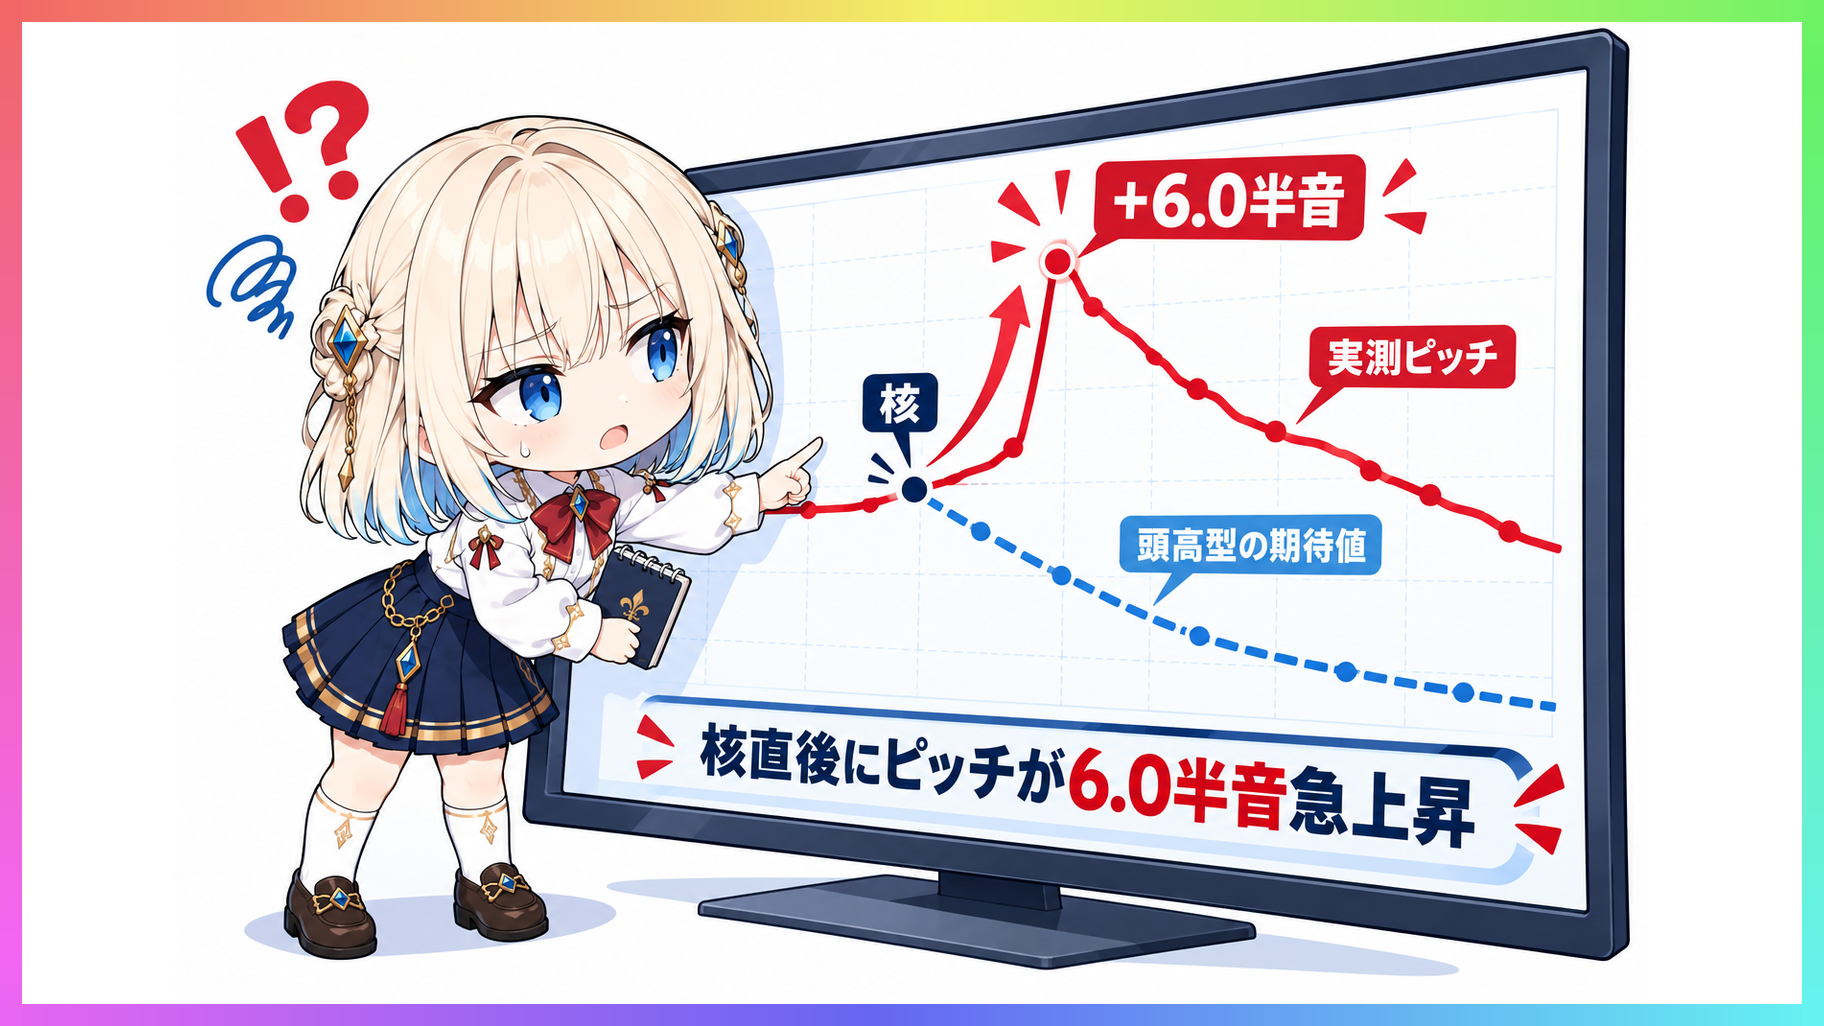
波形を切り出してピッチを測ると、対象の句は11モーラで構成されるアクセント第1類の頭高型だった。通常なら核の直後からピッチが下降するはずなのに、真逆へ急上昇している。
期待値: 核の直後からなだらかに下降(上限2.0半音以内)
実測値: 核の直後に +6.0半音の上昇
結果:   自動検査はスルーして合格判定
人間なら誰でも一発で違和感を抱くレベルの狂い方なのに、検査ログは完璧な無風状態だった。
機械の耳にはこれが正常な発声に聞こえていたらしい。
自動検査ロジックの盲点
品質検査のコードを追って理由が分かった。
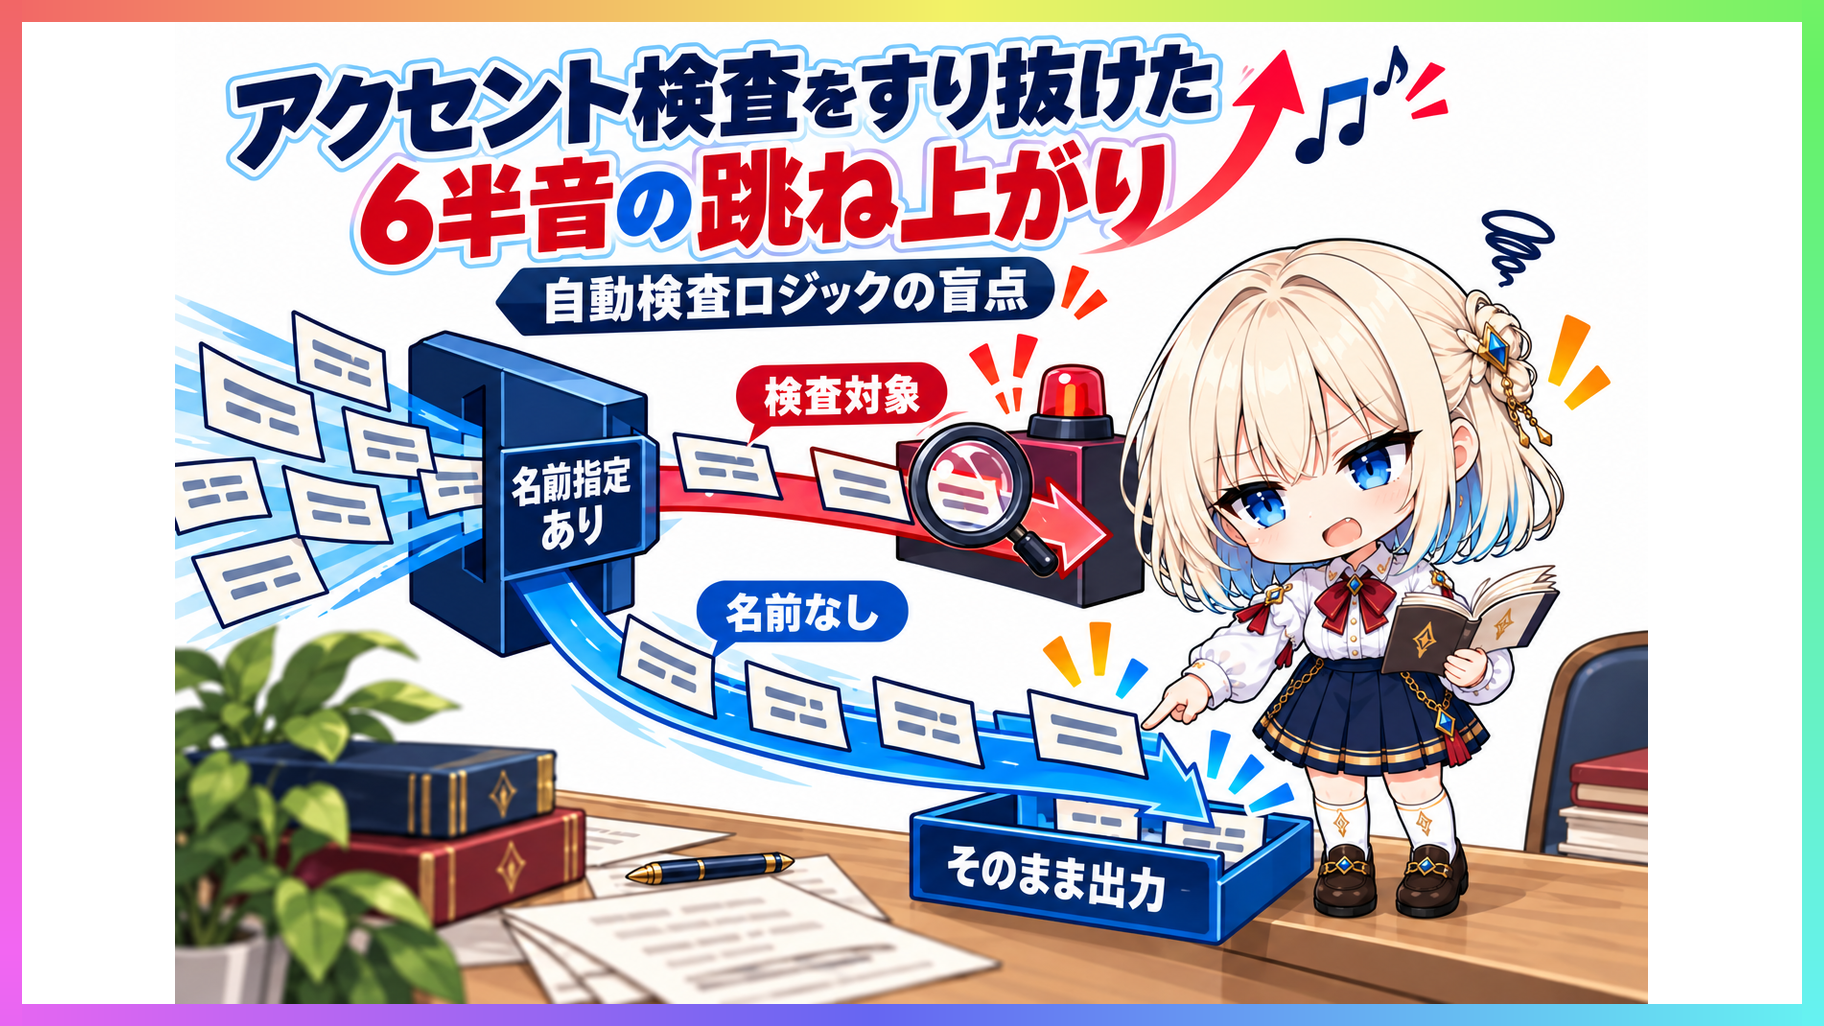
アクセントの自動検査処理は、人間が事前に名前を指定した句だけを修正対象にする設計になっていた。
名前のない一般的な句は、どれほど不自然にピッチが跳ねていてもそもそも検査対象から除外されていた。
CeVIO AI ユーザーズガイドの音素解説にある通り、日本語の共通語には頭高型や平板型などの型があり、アクセント句ごとにピッチの並びが決まる。
Fish Audioの音素制御仕様でもアクセント句単位で高低レベルを扱うように、音声合成において句の境界と型の認識は根本の要素だ。
しかし自作ツールの検査器は、全自動で全句をなぞるのではなく、指定された句だけを監視する省力化の設計を採っていた。
最初から見るつもりのない場所だった。
設定ファイルによる句の事前宣言
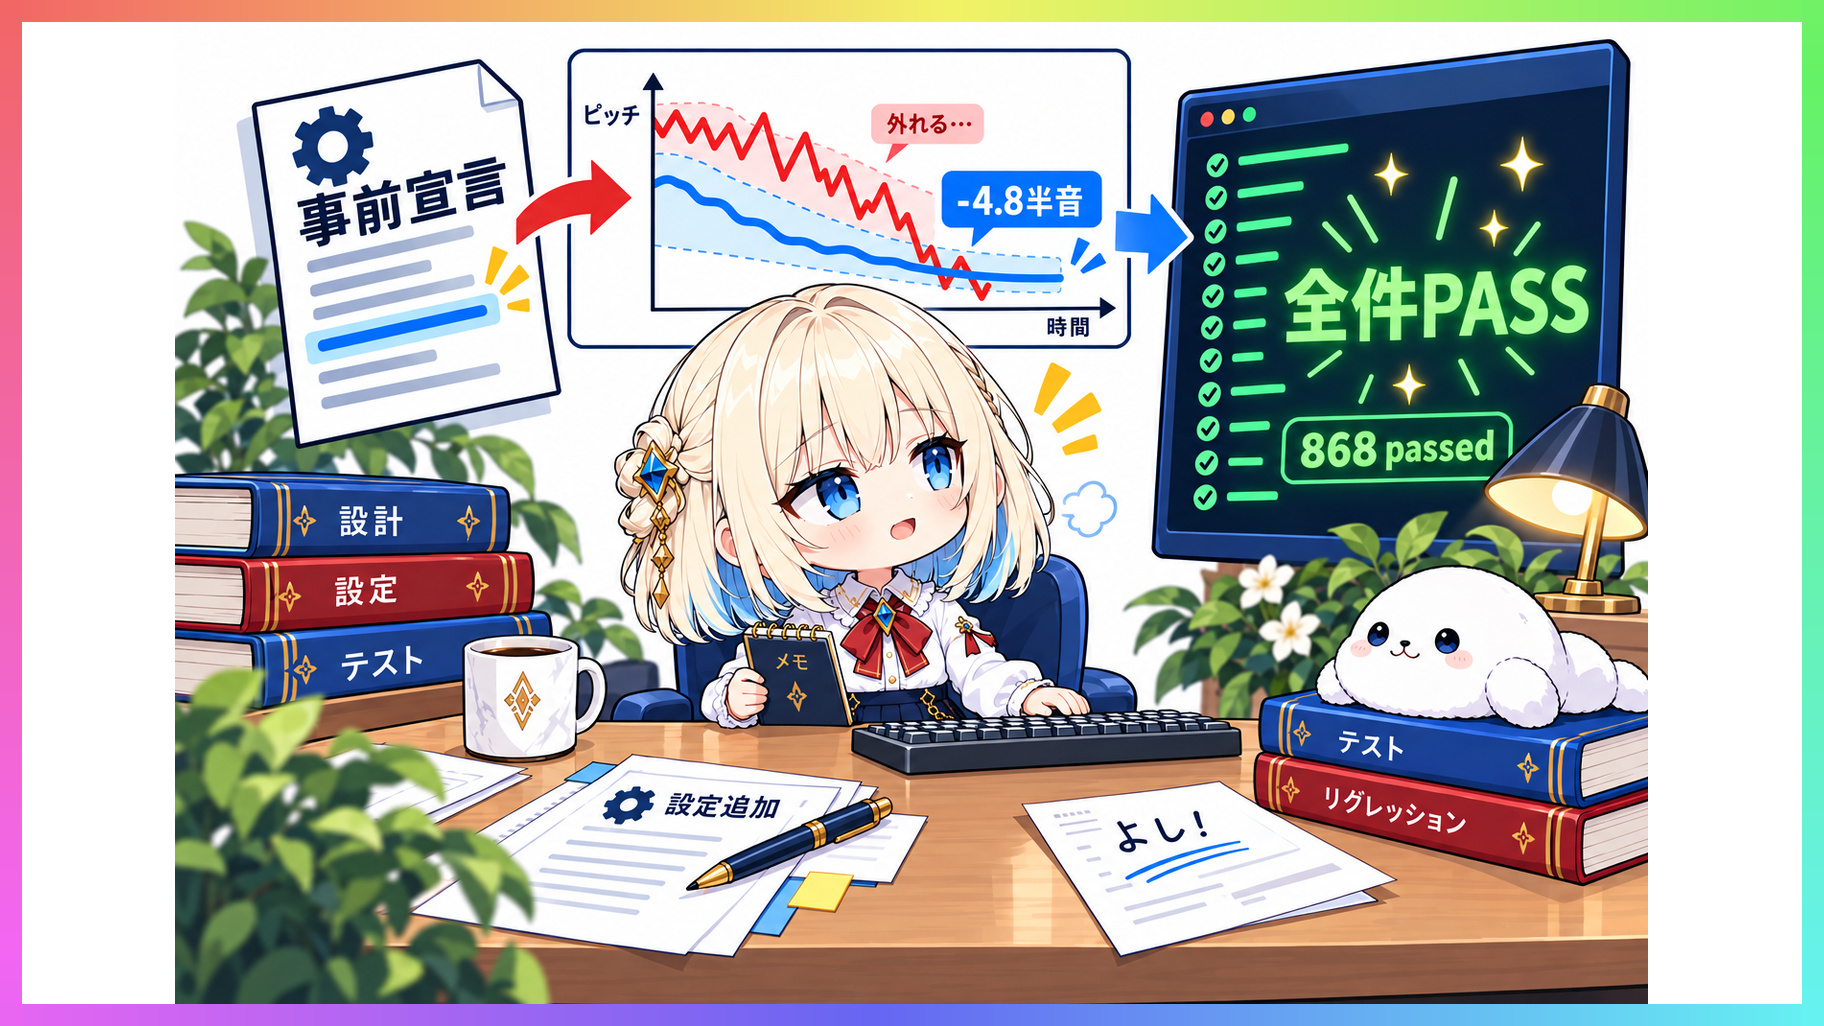
全句を無差別に検査対象へ広げると、わずかな揺らぎまで拾って音声の再生成が頻発し、生成時間が爆発する。そこで、問題が起きた句を設定ファイルに事前宣言して検査対象へ登録する方式をとった。
宣言を追加して再度ジェネレータを走らせると、検査器は末尾に生成されていた別テイクを選択した。
計測結果は次の通り大きく変わった。
| 項目 | 修正前 | 設定ファイル宣言後 |
|---|---|---|
| ピッチ変化 | +6.0半音(上昇) | -4.8半音(下降) |
| 準備 単体 | 判定外 | -1.90半音(許容上限2.0半音以内) |
| 検査判定 | スルー | 合格テイク選択 |
核直後の急上昇は解消され、頭高型らしい自然な下降ラインへ収まった。
リポジトリ全体の868件のテストもすべて通った。
対象外だった句をどう拾うか
今回の修正で特定フレーズのピッチ跳ね上がりは抑え込めるようになったが、この仕組みは設定ファイルに書いていない句には手を出さない。jpreprocessの実装のように形態素解析からアクセント句の結合まで自動で型を推定する仕組みを組み込まない限り、未知の句の破綻はすり抜け続ける。
全句検査で処理時間を犠牲にするか、設定ファイル方式で発見次第登録していくかは運用のトレードオフだ。
生成パイプラインの速度を落とさないためにも、未知の句はログと報告から見つけて設定ファイルへ足す運用で回す。
自動検査の網から外れた句を見つけ出す役目だけは、まだ私の耳から手放せそうにない。