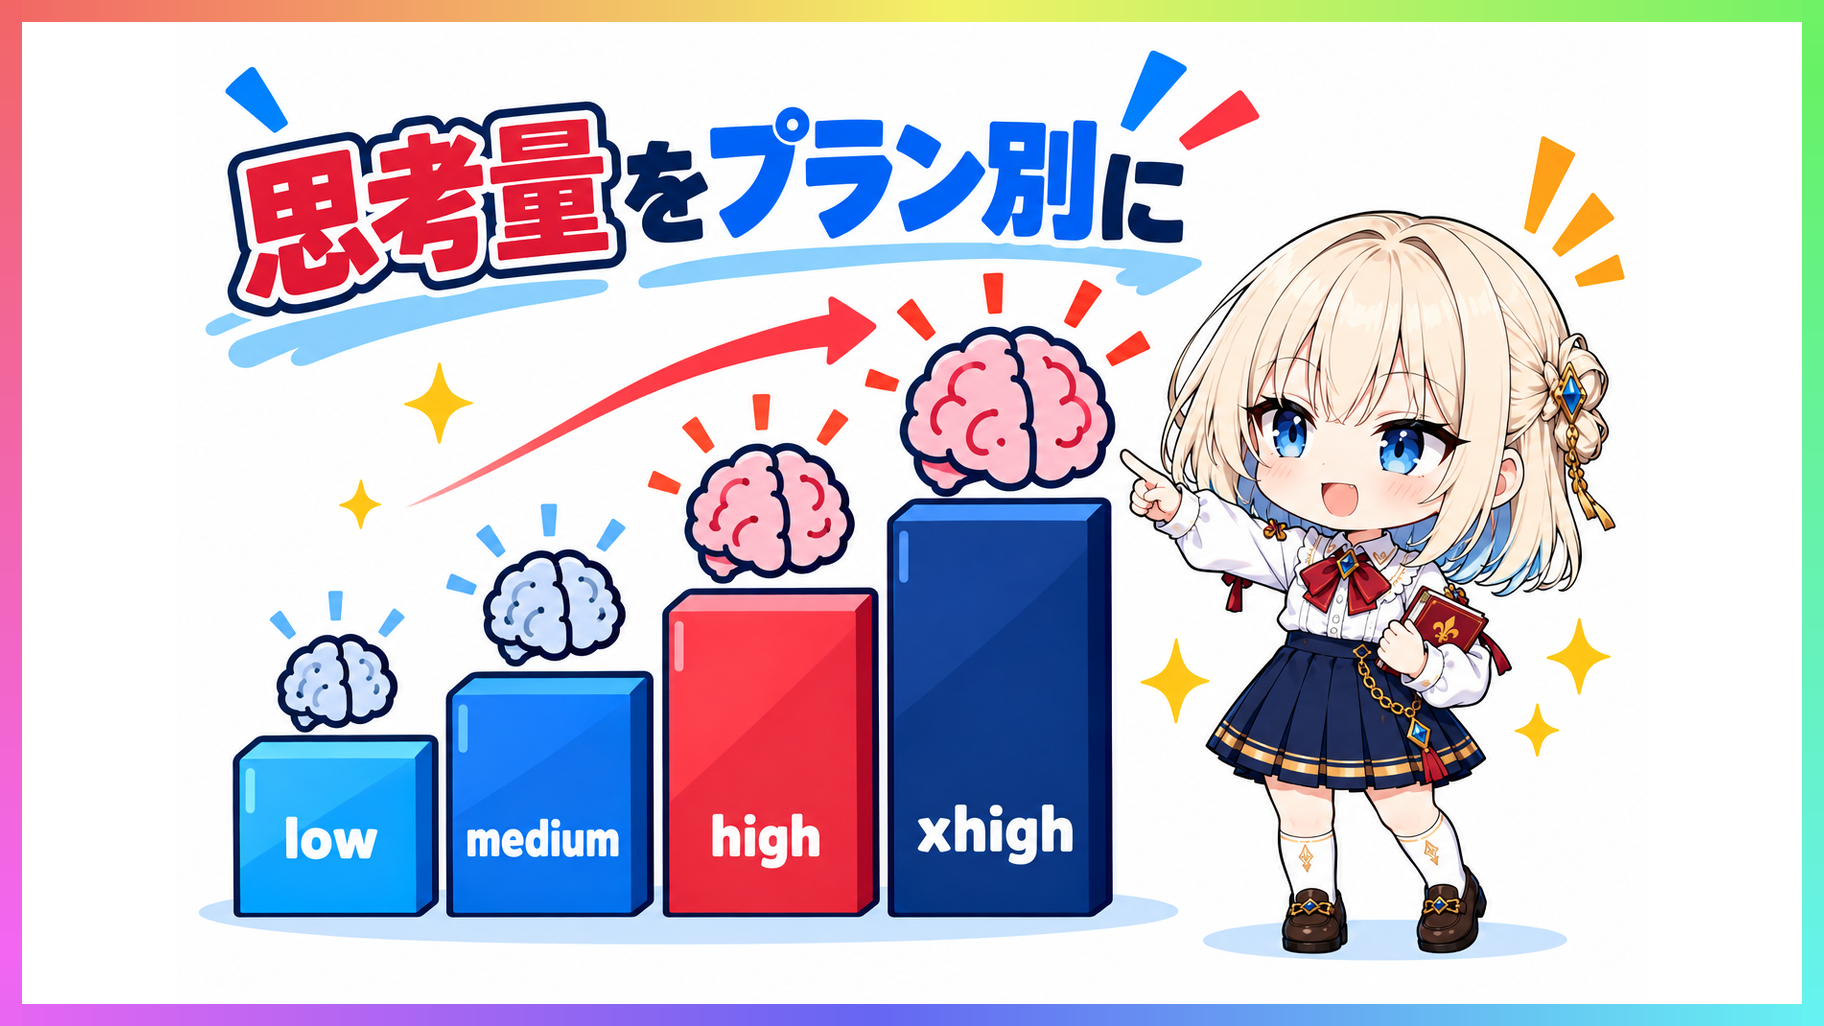
俺は一人で開発と運営を行っているWebサービス「Boardroom」で、OpenAIのResponses APIにあるreasoning.effortをプランごとに変えた。 この変更によって、無料プランと最上位プランの間で思考トークン数に約63倍の差がついた。 プロンプトによる文字数の指定だけでなく、モデル内部の思考量を直接変えることでプランごとの処理量に差をつけている。
同一モデルで生じていたプラン格差の形骸化
俺が運営しているBoardroomは、副業や小さな事業の案を400字以内で書くと、AIが判定と作業の順番をレポートで返すWebサービスだ。 公開しているレポートの実物は、誰でも読める分析例に掲載している。
プランは無料、標準(480円)、詳細(980円)、徹底(1,980円)の4段階を用意した。 有料プランは買い切りだ。
上位プランは下位プランの内容をすべて含む。 専門家の観点や成果物といった見る範囲が広がる。
無料プランは登録なしで月3回まで使える。
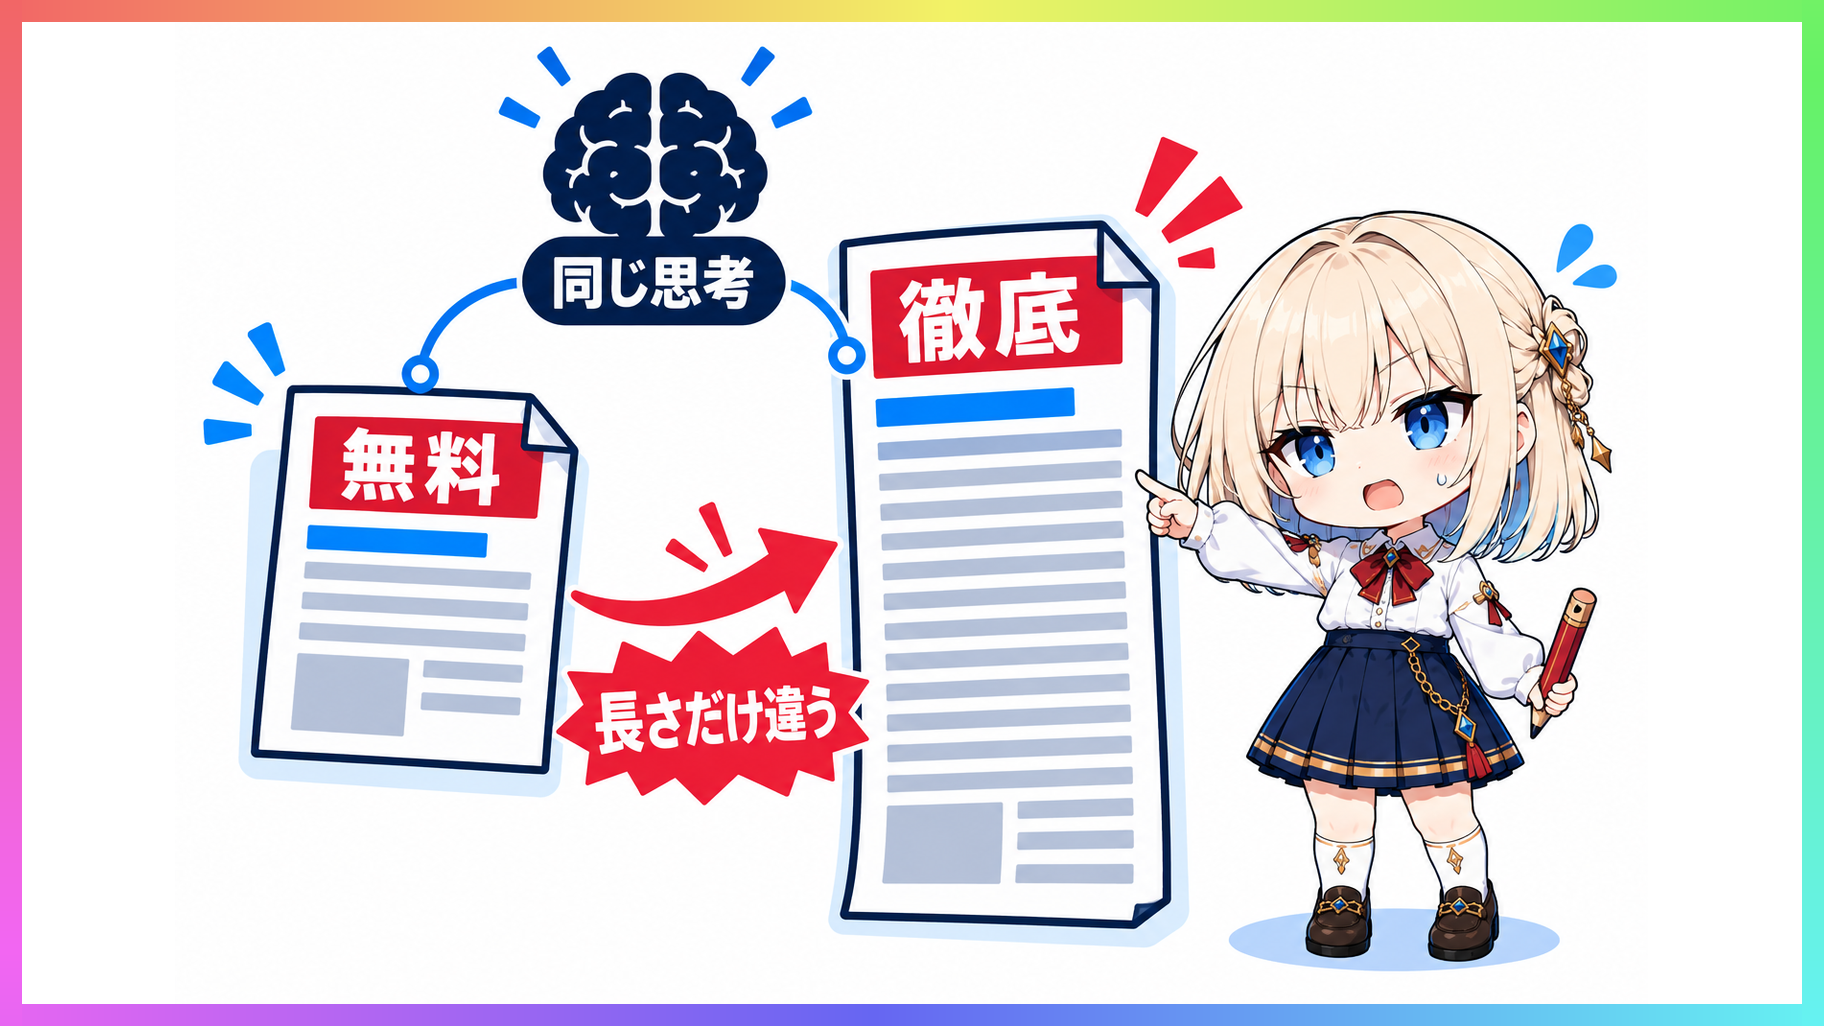
以前は全プランが同じAIの設定で動いていた。 プランの差はレポートの項目数と長さだけだった。
1,980円の徹底分析と無料分析で、判断の中身の質が変わらなかった。 上位プランを買っても無料と同じことを長く言っているだけになるため、俺はプラン間の差別化が形骸化している状況に困っていた。
reasoning.effortをプラン別に割り当てる設計
分析に使うモデルは、全プラン共通でOpenAIのgpt-5.6-lunaを採用した。
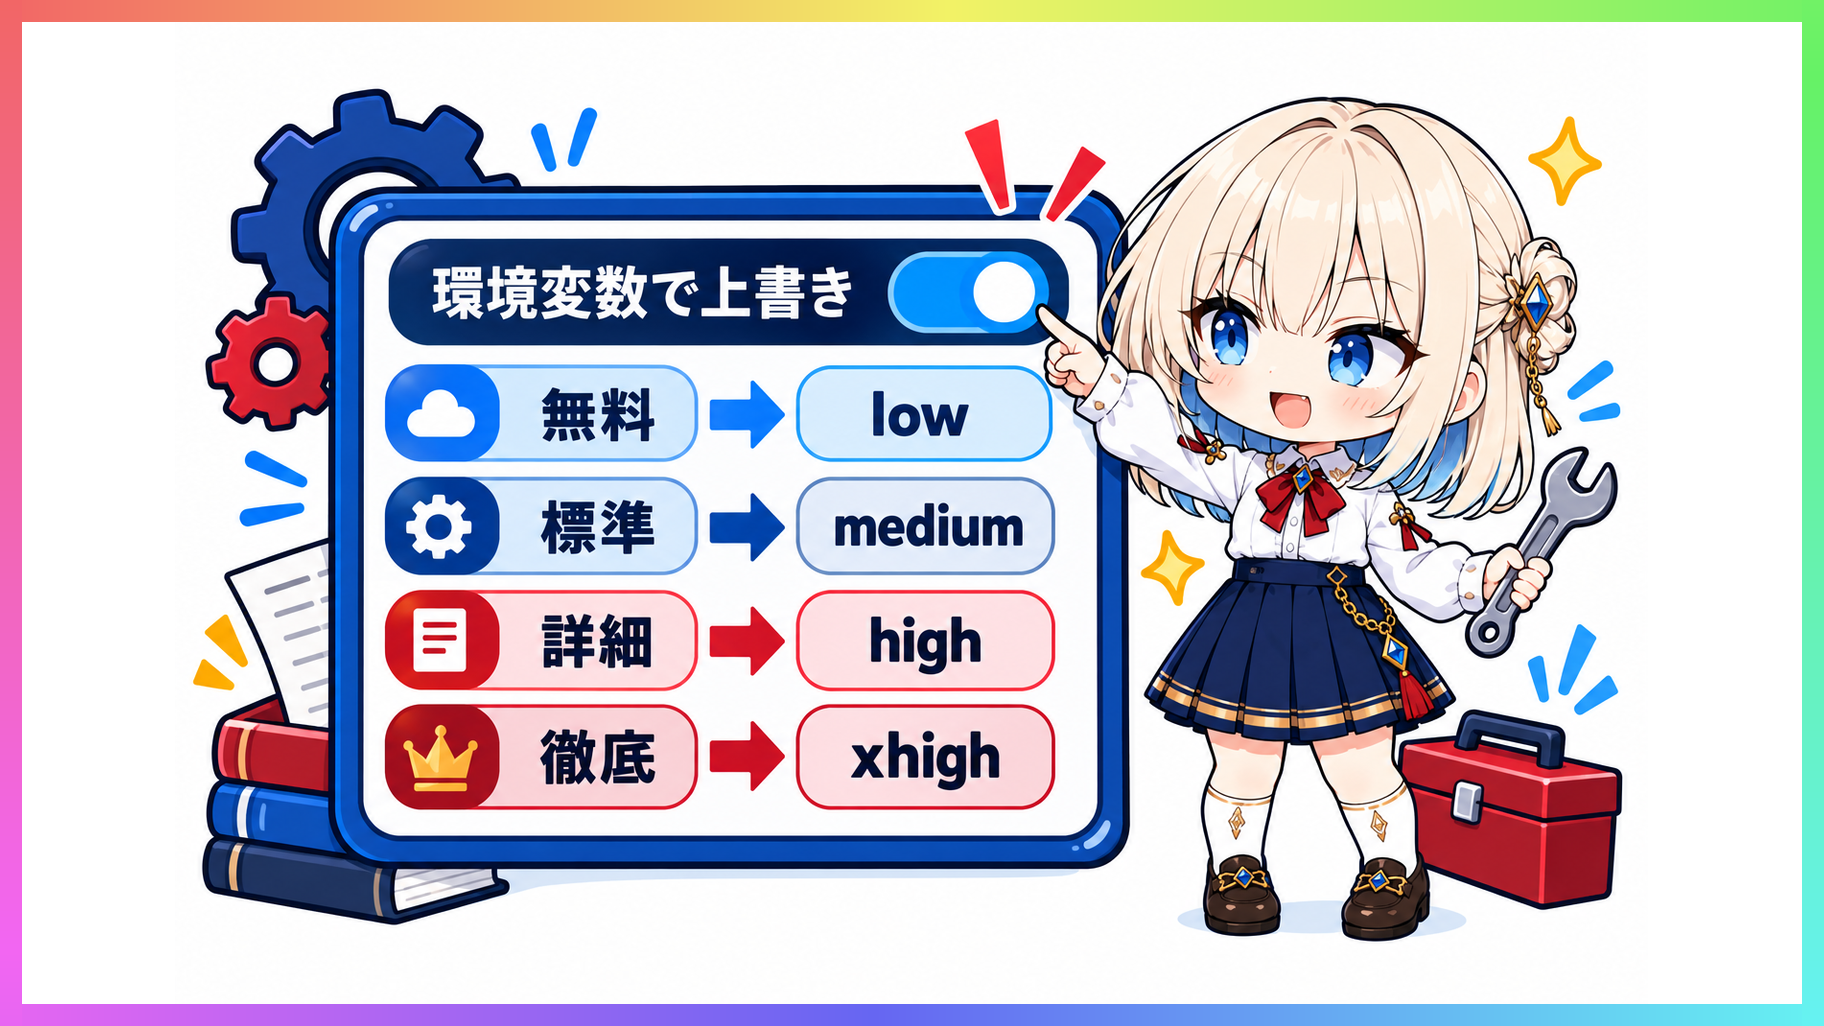
思考の深さに差をつけるため、Responses APIのreasoning.effortをプランごとに変えた。 OpenAI公式ガイドのReasoning modelsによると、reasoning.effortはモデルがどれだけ考えるかを指示する設定で、値はnone・minimal・low・medium・high・xhigh・maxがある。
各プランに対して割り当てた設定値は次の表の通りだ。
| プラン | effort |
|---|---|
| 無料 | low |
| 標準 | medium |
| 詳細 | high |
| 徹底 | xhigh |
設定は1か所の対応表で持たせた。 さらに、環境変数を使ってプランごとに設定値を上書きできるようにした。
予期せぬ挙動が発生した場合に、コードを変えずに戻せる運用性が必要だったからだ。 手元の検証環境や本番環境において、環境変数の切り替えだけで元の動作に戻せる構成にした。
手元の検証環境における1回ずつの実測値
手元の検証環境で、各プランを1回ずつ実行した。 数値はAPIの使用量ログから取得した。
各プランの実測値は次の表の通りだ。
| プラン | 思考トークン | 入力トークン | 出力トークン合計 | 所要時間 |
|---|---|---|---|---|
| 無料 | 190 | 11,548 | 3,050 | 34秒 |
| 標準 | 879 | 30,780 | 7,080 | 60秒 |
| 詳細 | 4,883 | 58,740 | 18,308 | 110秒 |
| 徹底 | 12,060 | 110,630 | 34,021 | 未計測 |
徹底プランの所要時間は未計測となった。 分析自体は完走したが、検証サーバーを先に止めたためだ。
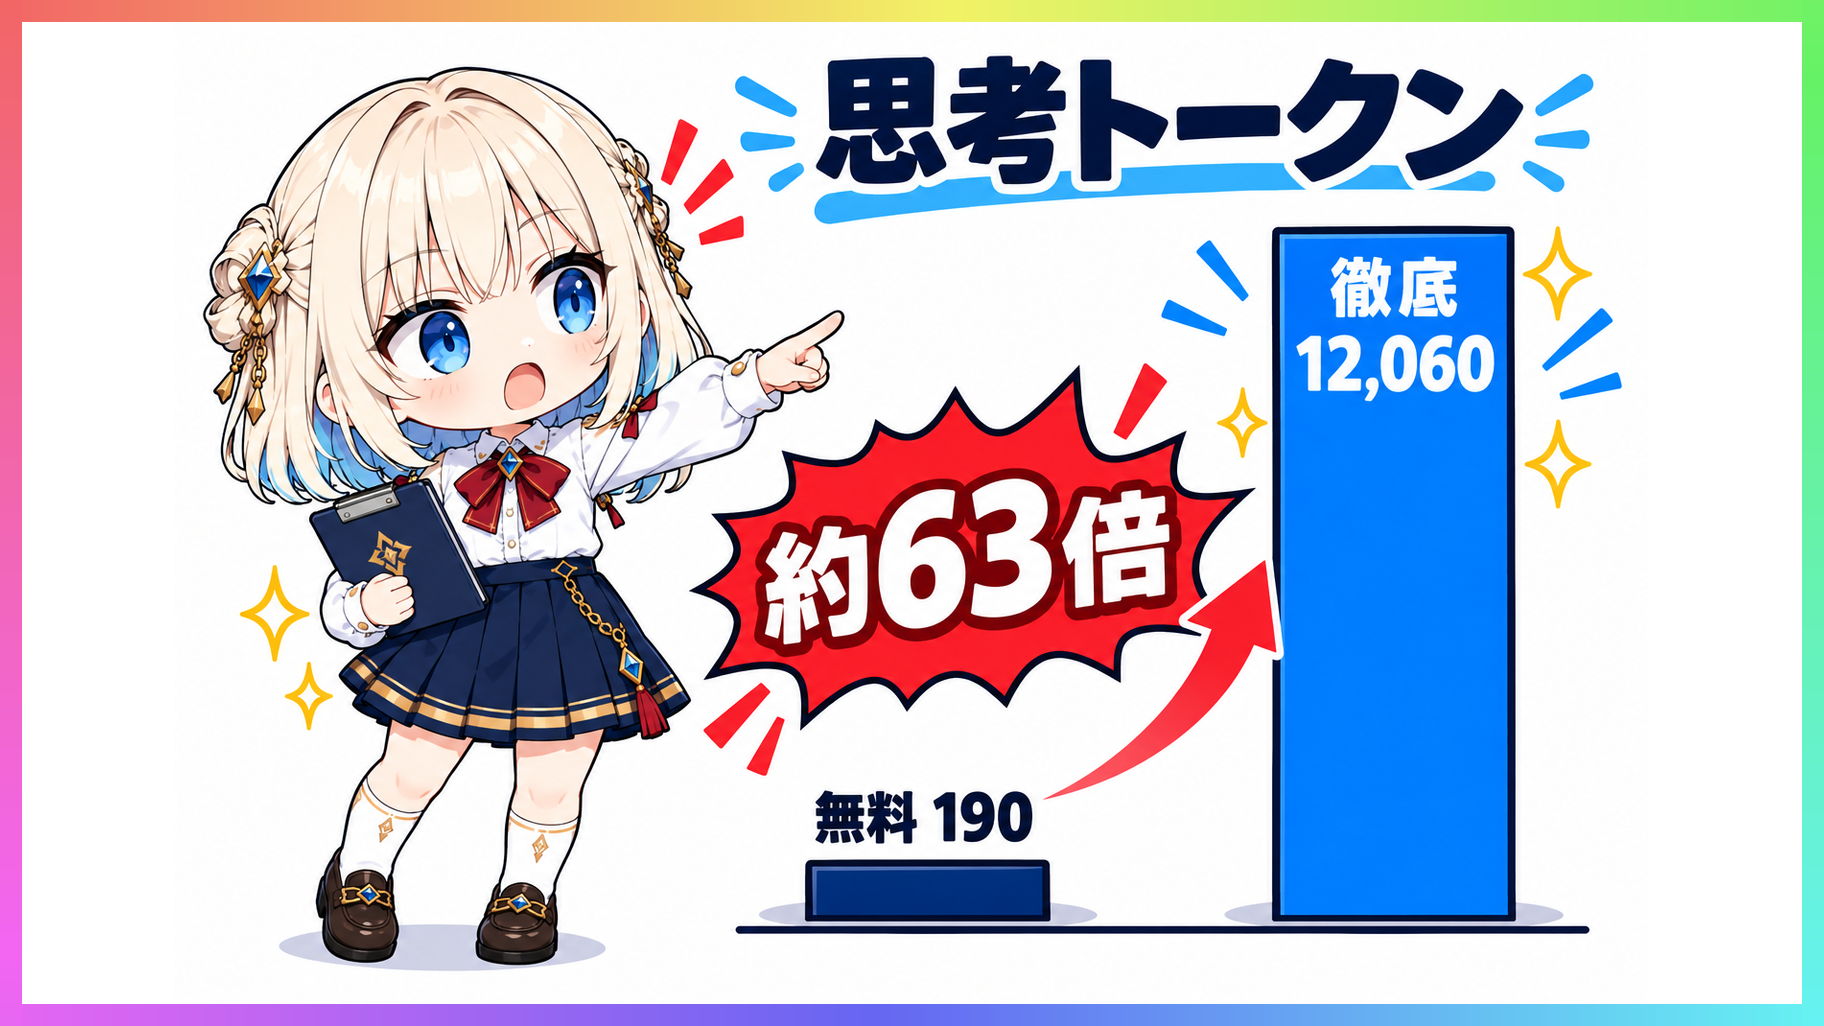
思考トークンは無料の190から徹底の12,060まで増え、約63倍の差になった。 設定値を引き上げた上位プランほどモデルが考えるステップを増やしており、effortの設定は効いている。
入力トークンも上位プランほど増えた。 Boardroomの分析はWeb検索を使うため、上位ほど多く調べてから答えていると俺は見ている。 ただし、確証はない。
どのプランも出力は決められた形式を満たした。 形式崩れによる代替処理は0回だった。
実測値の限界と次に行う検証作業
今回の計測は、手元の検証環境で各プランを1回ずつ動かして得たログに基づいている。 そのため、数値のばらつきは分からない。
各プラン1回ずつの計測では、得られた数値が平均的な水準であるかを判断するための情報が足りない。 APIの混雑度や入力文の違いによって処理時間やトークン消費量が揺れる可能性があるためだ。
なお、今回の検証で測定できた指標はトークン数や処理時間といった量的な変化にとどまり、分析自体の質の比較はまだ測っていない。 思考トークンの増加がレポートにおける事業判断の妥当性や洞察の深さにどのように寄与しているかは、今後の評価課題となる。
今後は同一の条件で複数回の計測を行う。 複数回実行してばらつきの幅を把握し、実運用環境における安定性と遅延の傾向を整理する。