ネットの話題を拾って短い解説動画を作る自作ツールを動かしていた。
できあがった台本を読み直した瞬間、強い胸焼けが走った。
全編がツッコミで埋まっていた。
「A案の方がマシだけど毎回最後に一言を付けるのがウザイ」と自分で吐き捨てた。画面が切り替わるたびに、台本のキャラクターが短い感想やボケを漏らし続けている。静かに事実を渡すシーンが1つも存在しない。
本来なら出来事の推移を淡々と渡すべき場面でも、語尾にわざわざ反応をねじ込んでくる。静けさを保てない台本ほど、見ていて疲れるものはない。
全画面ツッコミの台本
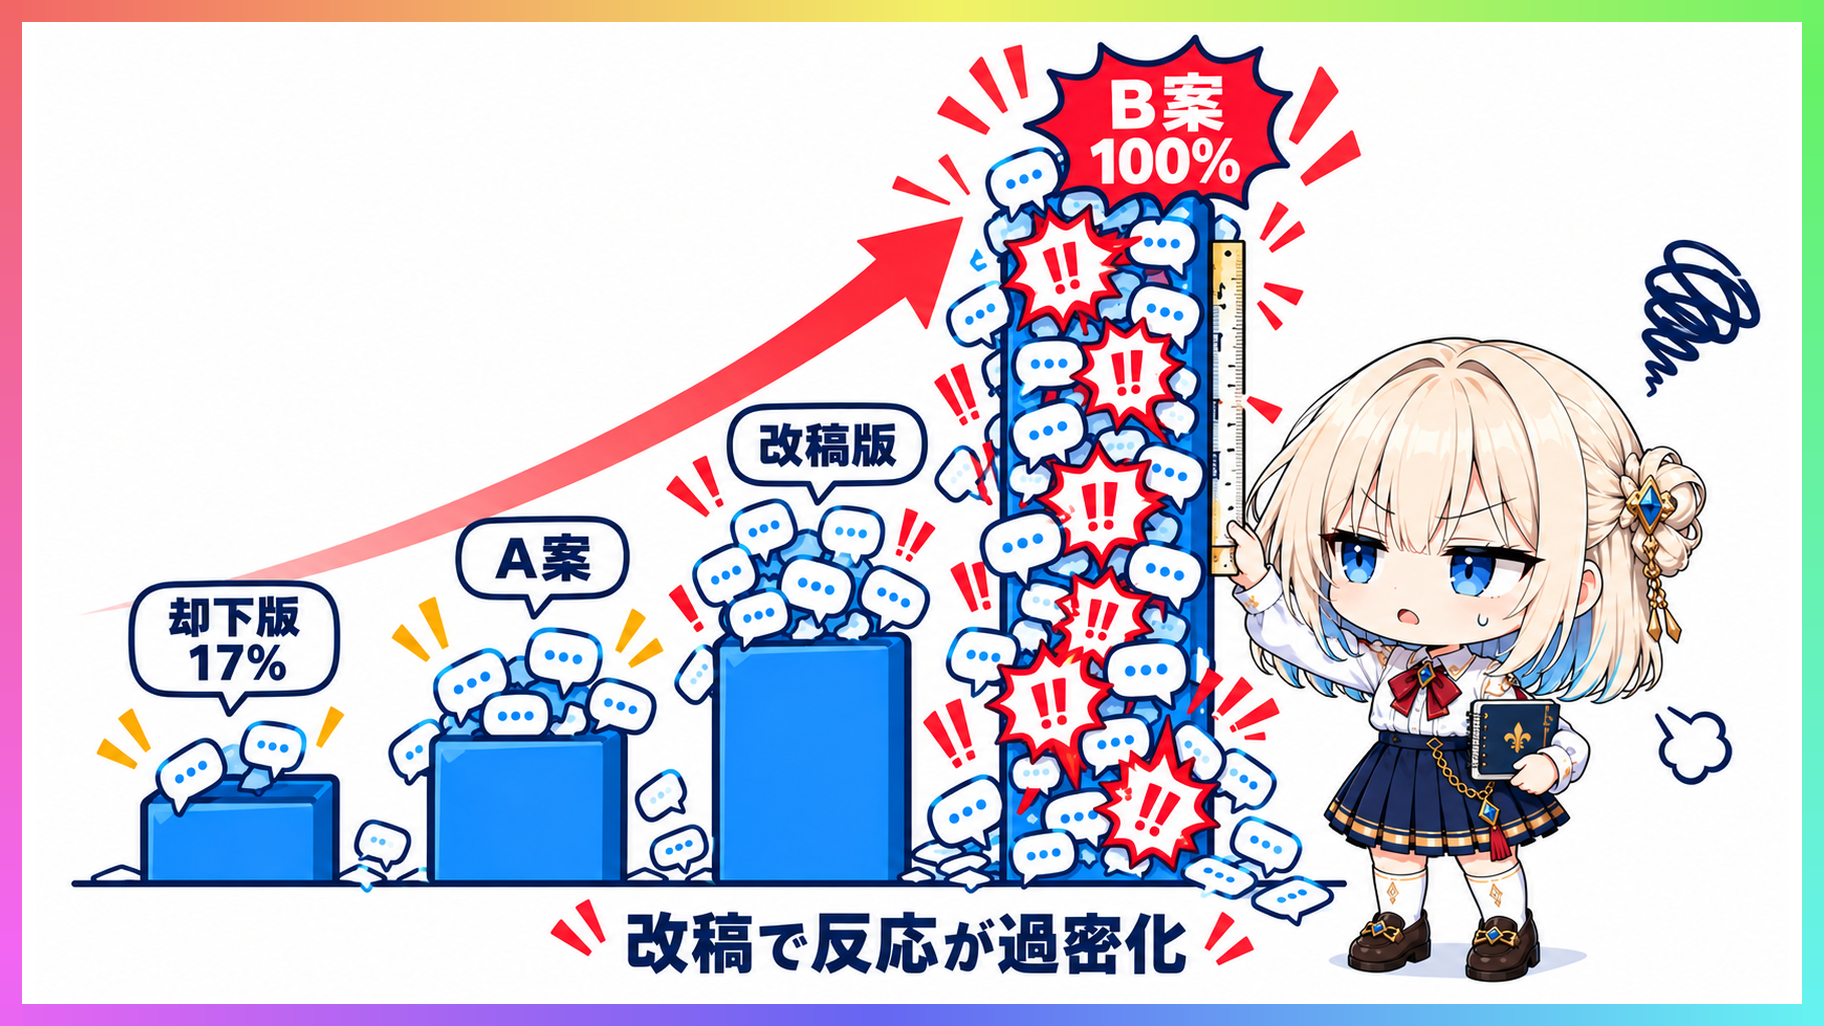
ツッコミの割合を数えると、全シーンの100%に達していた。動画の尺は決まっている。そこに過密なリアクションが敷き詰められた結果、どの台詞も同じ重さでぶつかり合っていた。
| バージョン | 反応率 | 台本の状態 |
|---|---|---|
| 却下版 | 17% | 事実の単なる羅列 |
| A案 | 25% | マシと判断した状態 |
| 承認済み旧版 | 67% | 反応が多めの構成 |
| B案 | 100% | 全シーンがツッコミで着地 |
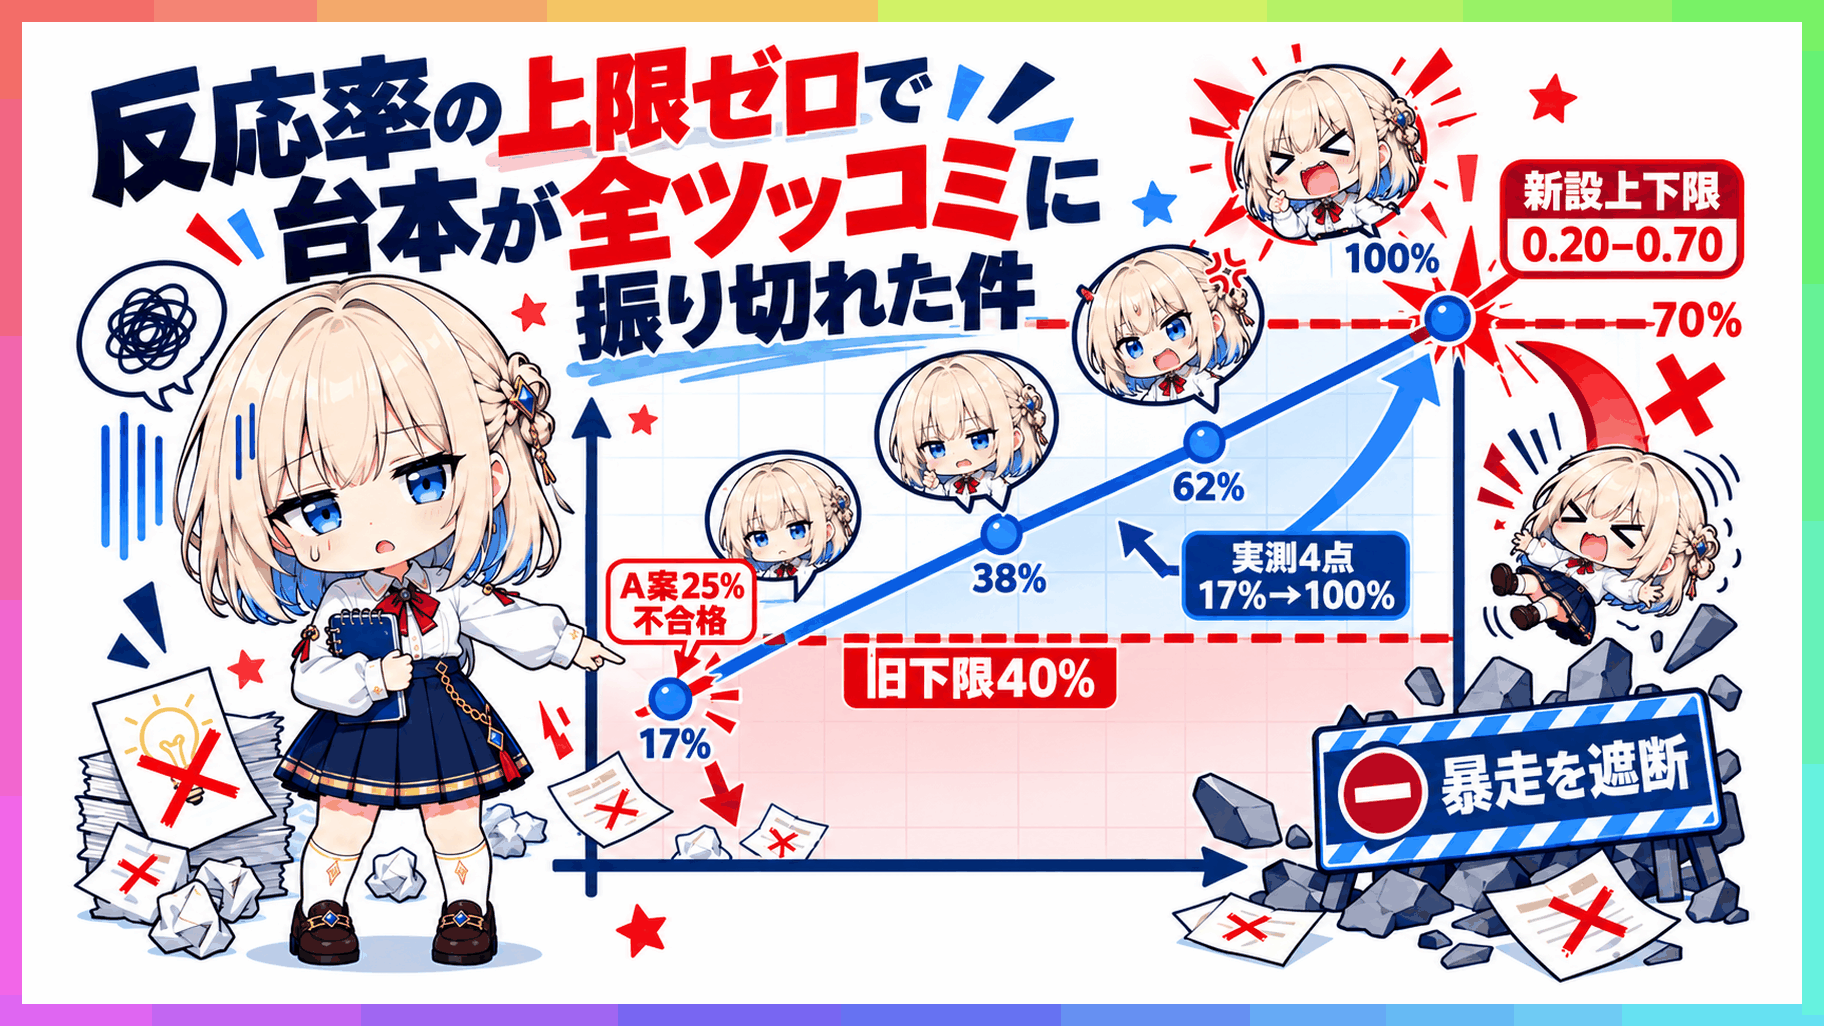
実測の数値は25%から100%へと単調に悪化していた。
ツール内の検査処理には、反応率の下限として40%が設定されていた。だが、上限の規定はどこにも存在しなかった。
4点の実測と旧判定
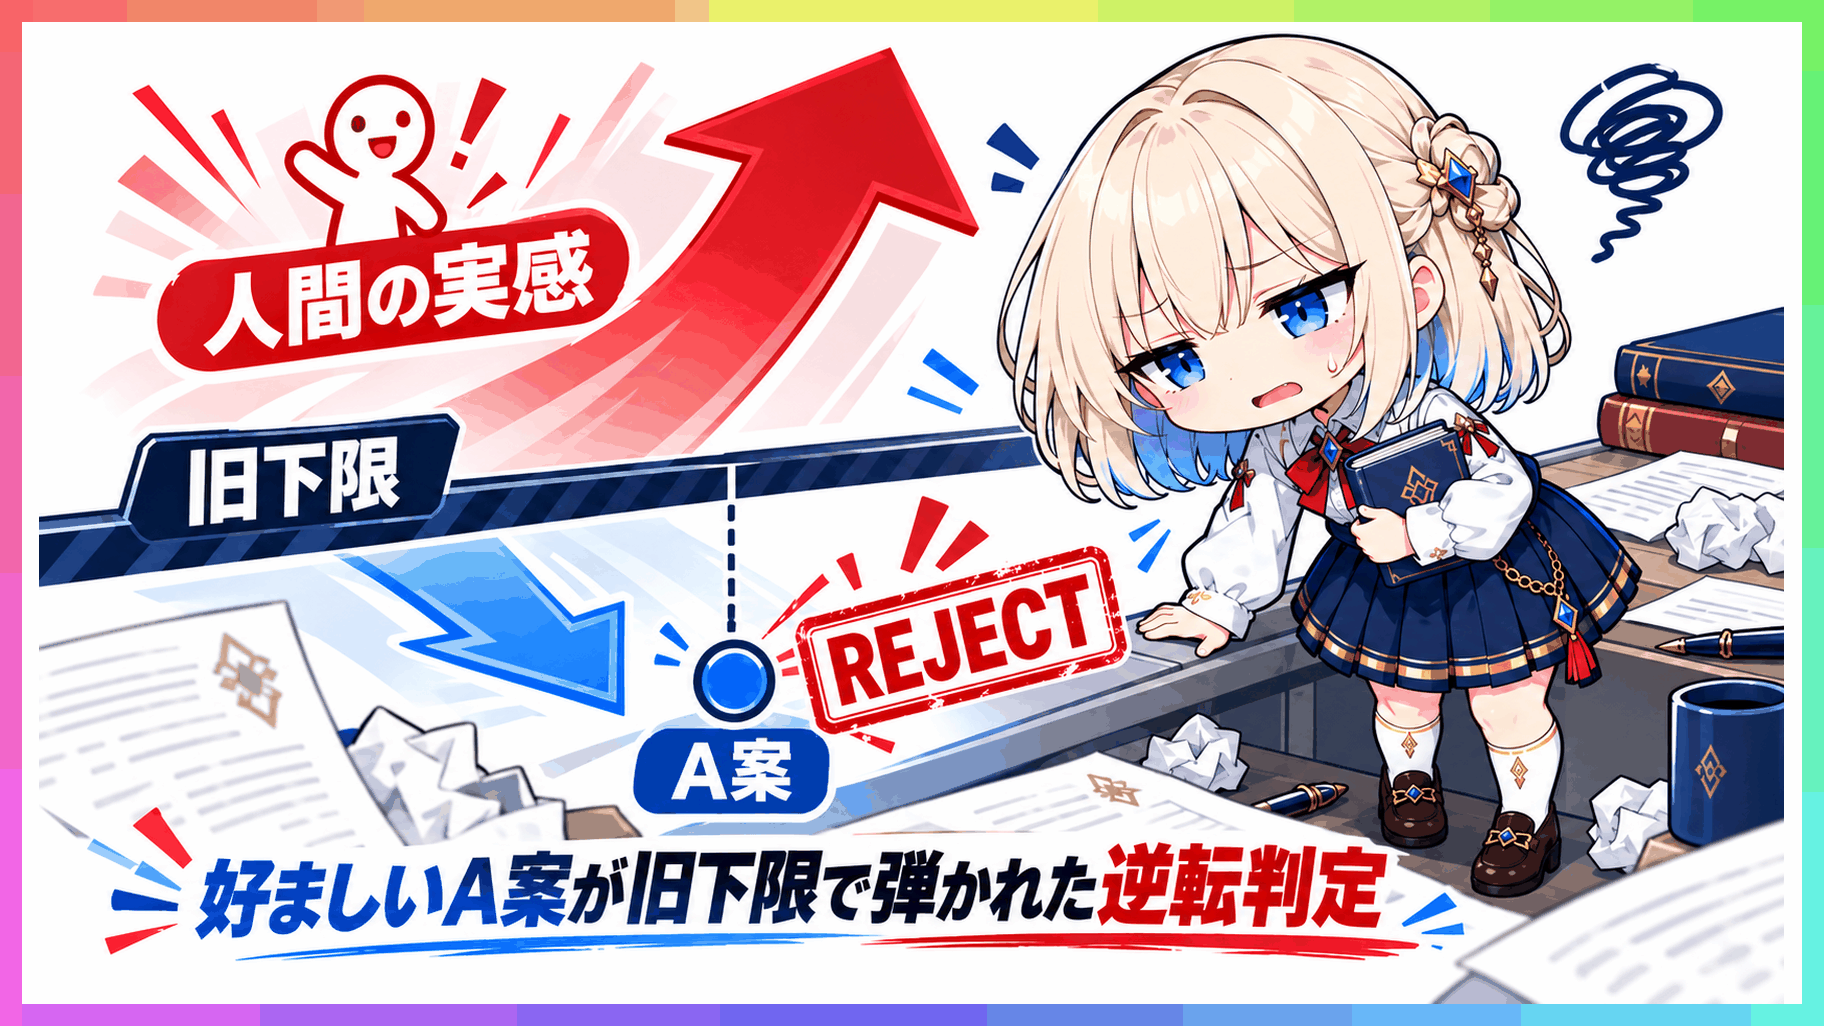
古い検査処理は、私が「マシ」と判断した25%のA案を不合格に弾いていた。
好ましいと感じた記述を機械が落とし、うるさくて不快なB案を素通りさせている。
# 修正前の検査設定
REACTION_MIN = 0.40  # 下限のみ存在
# 上限の定義は存在しなかった文章検査のツールであるValeのMinAlertLevel仕様では、重大度の設定によってCIを落とす警告を制御できる。しかし今回の問題は、重大度の配分以前に検査の向きそのものが逆転していた点にある。
対抗する指標として「末尾が短い一言で終わる率」も計測してみた。承認済み版が67%、A案が75%、B案が60%という結果が出た。
この数値はまるで分離しない。
良し悪しの境界を引けない指標をいくら監視しても、意味のある合否判定は作れない。作りかけた判定処理はその場で捨てた。
4ファイルの指示対決
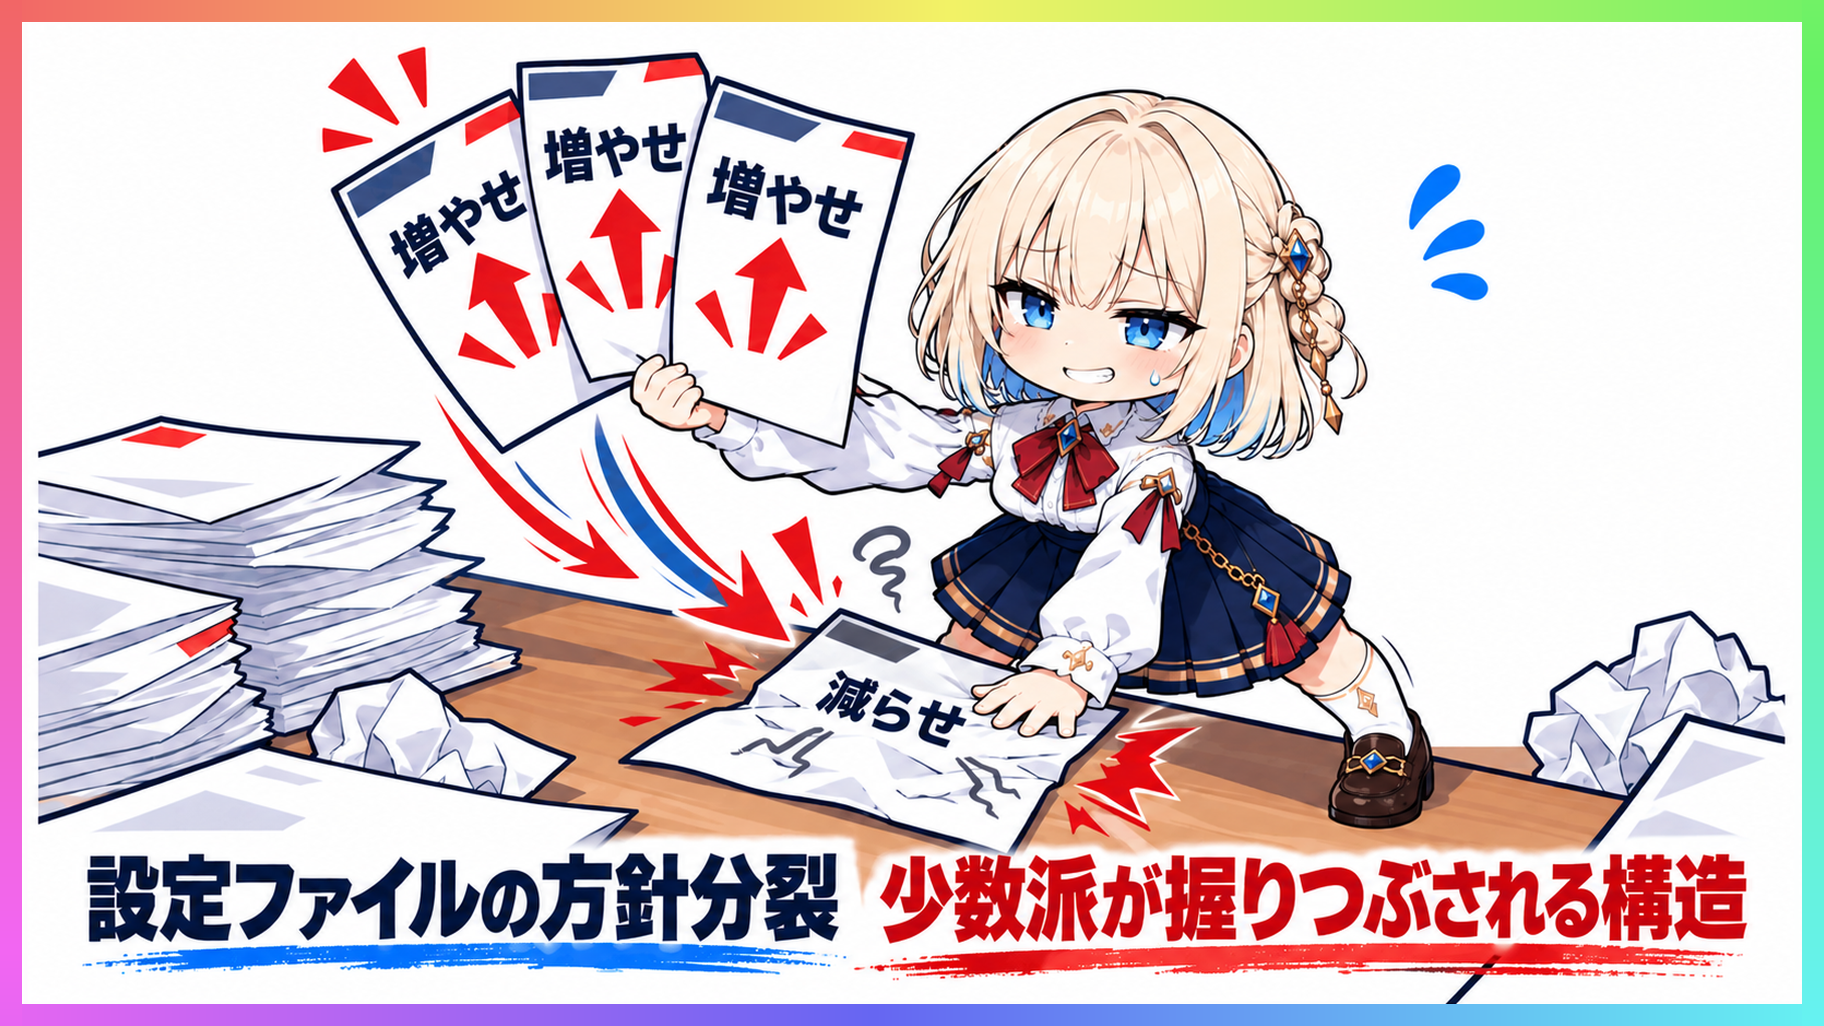
なぜ生成処理は反応を100%まで増やし続けたのか。設定ファイルを洗い出したところ、同じスタイル方針が4つのファイルに散らばって正反対の指示を出していた。
- 設定ファイル1: 全シーンをツッコミで終えるな、3〜5シーンまでに抑えろ(減らせ)
- 設定ファイル2: 全シーンに反応を乗せろ、事実だけのシーンを書くな(増やせ)
- 設定ファイル3: ツッコミは新情報ゼロでも絶対に削るな(減らすな)
- 設定ファイル4: 検査コードの下限40%のみ、上限なし(増やせ)
多数決の結果は3対1で「増やせ」の圧勝だった。
しかも、台本を書く言語モデルが直接読み込むプロンプトには設定ファイル2が注入されていた。
以前の作業で「全ツッコミもクドい」と感じて書き足したルール8は、設定ファイル1の片隅で完全に孤立していた。
自然言語で指示を増やす運用は、プロンプトと検査ゲートの物量差の前に脆くも崩れ去る。
上下限の新設とAI検査
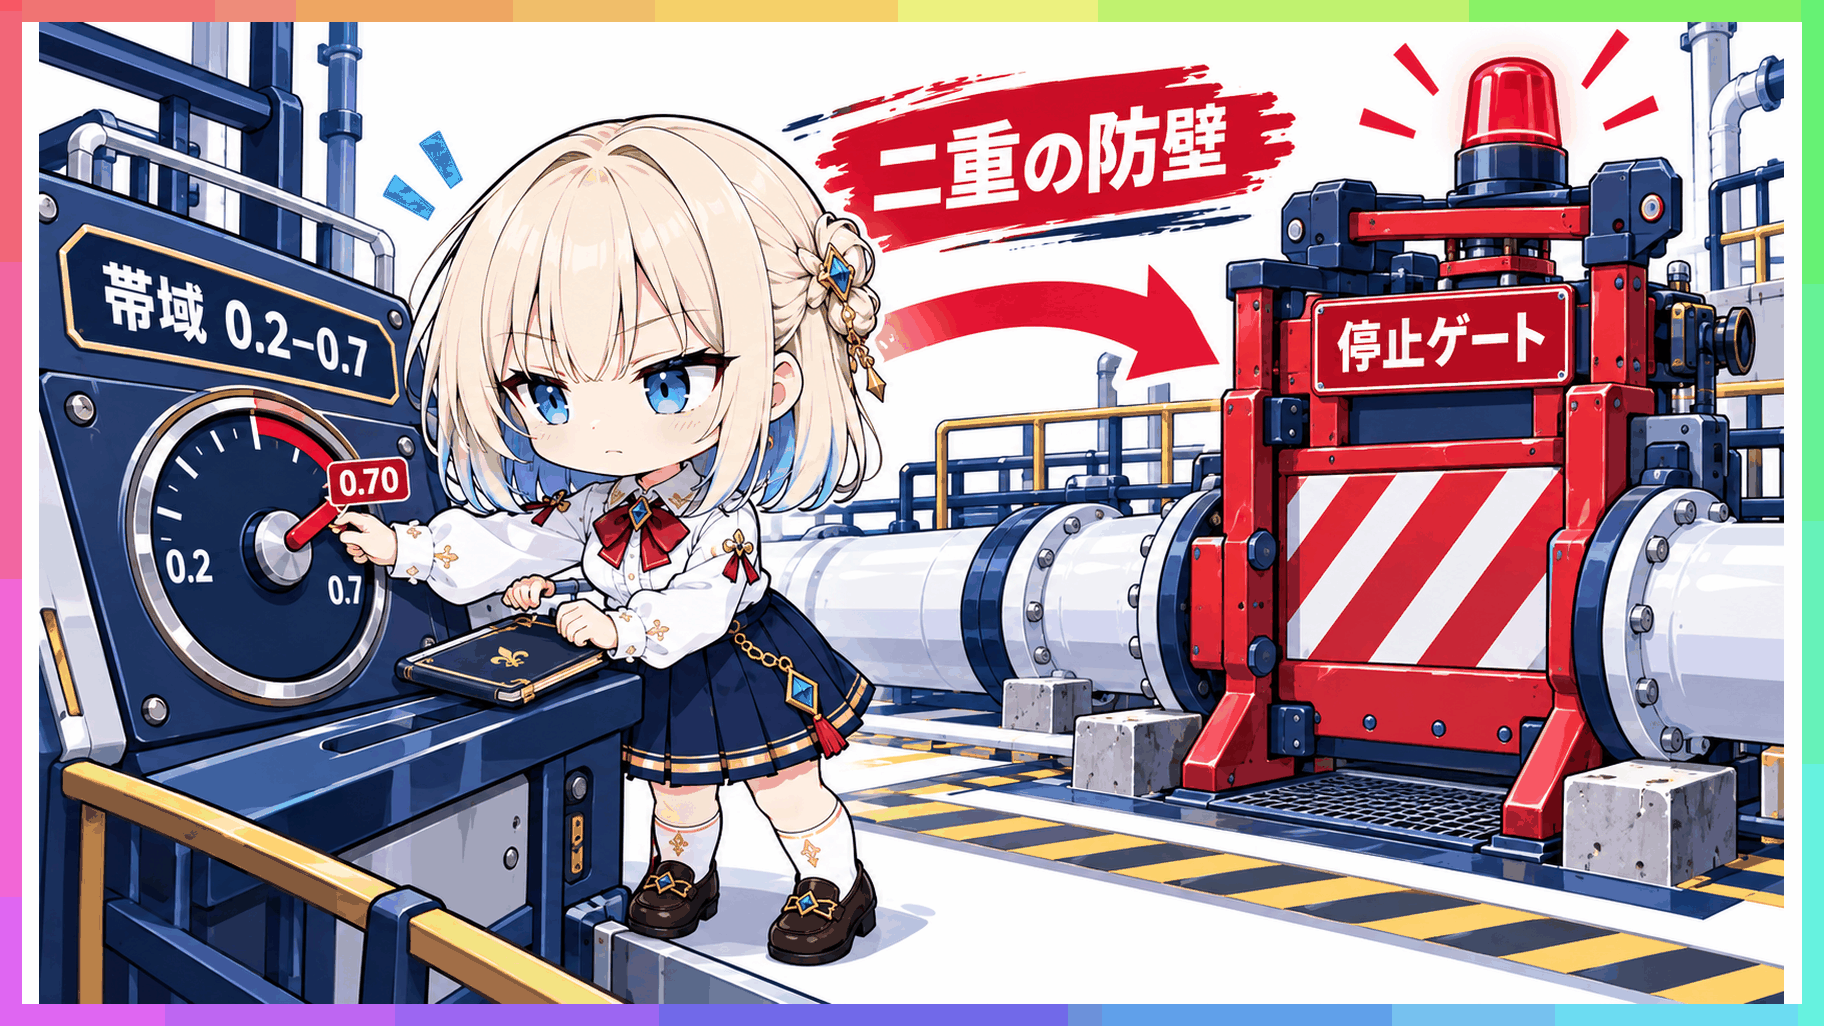
解決のために、散らばっていた文言設定を単一の数値指標へ統合した。
# 修正後の検査設定
SCRIPT_REACTION_MIN = 0.20
SCRIPT_REACTION_MAX = 0.70下限を0.20へ引き下げ、0.70の上限を新設した。textlintの技術文書向けプリセットが1文の長さや読点の数に明確な閾値を設けるように、文体は上下の限界値で縛る必要がある。
さらに検査メッセージの中に残っていた「各シーンに必ず1つ乗せる」という押し上げ文言を完全消去した。
4ファイルに散っていた数値がズレた瞬間に自動テストが赤く落ちる仕組みも導入した。不整合を未然に防ぐためだ。テストケースは100件から109件へ増え、すべて緑色で通過した。
ただ、数値ゲートだけでは文自体の意味の破綻を防げない。
「これで独立って言える人」のように助詞が抜けた文や、冒頭に主題のない文を、従来の検査項目は1件も拾えなかった。既存の検査対象を一覧化したところ、文字数、語尾の連続、禁止語など表層の形式チェックしか持っていなかった。
そこで意味の成立を確認するAIレビュー処理を新設した。JSON Schemaの機械可読仕様を参考に判定用の出力構造を厳密に定義し、llm-schema-validatorの設計に倣ってレビュアーが正当な判定結果を返さない場合はパイプライン全体を止める構成にした。
100%のツッコミを嫌って上限を0.70に縛ったのに、台本からツッコミが完全に消え去ったのはAPIの残高が尽きて判定ごと落ちた瞬間だ。